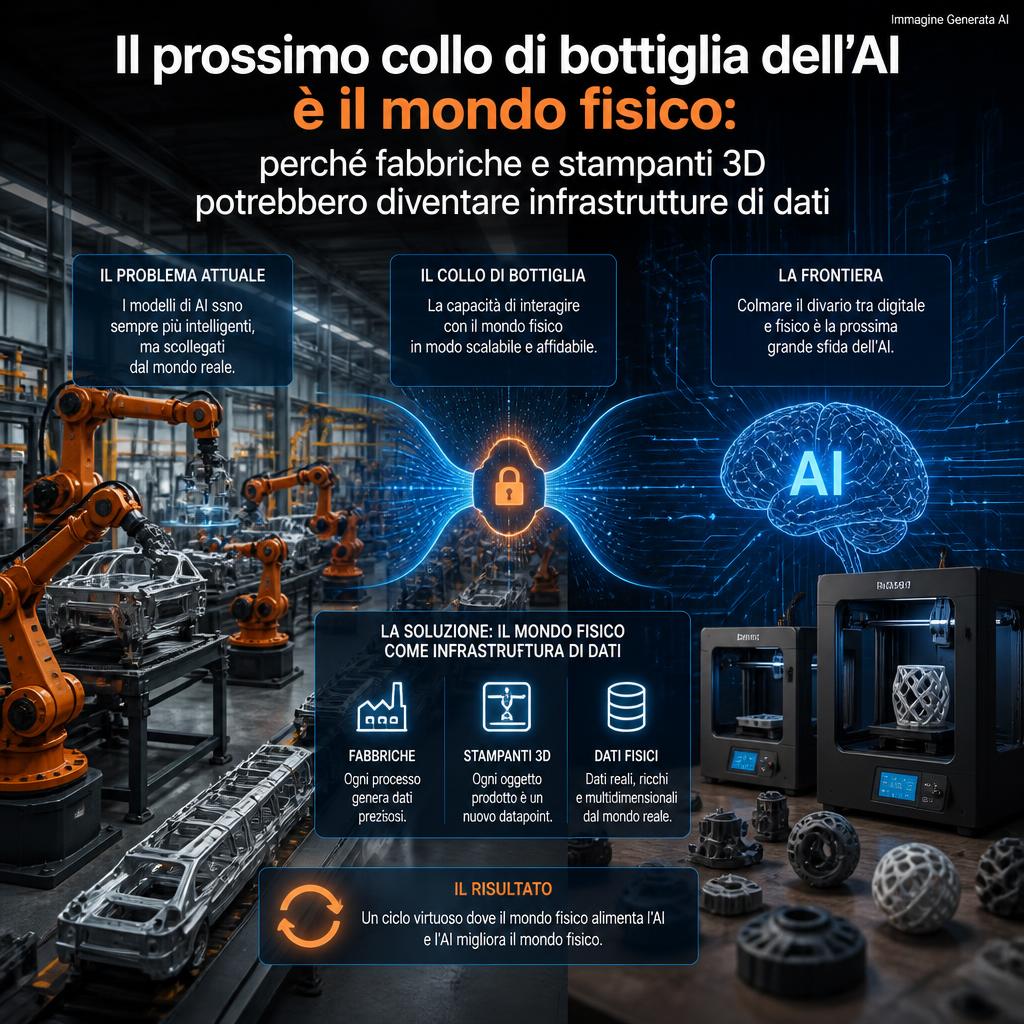
Per la prima fase dell’intelligenza artificiale moderna il mondo aveva già preparato buona parte della materia prima necessaria. Decenni di Internet avevano accumulato testi, fotografie, video, codice software e documenti in quantità enormi. I Large Language Model hanno potuto imparare da una parte significativa di questa produzione digitale senza doverla creare fisicamente da zero. La situazione cambia radicalmente quando l’intelligenza artificiale deve uscire dal monitor e controllare un robot, un’automobile, una linea produttiva o una stampante 3D. Un modello linguistico può produrre una frase sbagliata e rimanere comunque utile; un sistema che guida un’automobile, regola un laser da centinaia di watt o decide se un componente aeronautico sia conforme incontra un benchmark molto meno tollerante: la realtà fisica.
È la tesi che attraversa l’analisi di partenza dopo il Sifted Summit 2026 di Londra, dove investitori, ricercatori, aziende e rappresentanti governativi hanno discusso il passaggio dalla generative AI alla cosiddetta physical AI. Non si tratta di una singola nuova tecnologia e neppure di un’architettura precisamente definita. Physical AI viene utilizzato sempre più spesso come termine ombrello per sistemi capaci di percepire un ambiente, costruirne una rappresentazione, prevederne l’evoluzione, prendere decisioni e compiere azioni attraverso veicoli, robot o macchine industriali. Il passaggio fondamentale è quindi da generare informazioni a generare azioni.
AlphaFold mostra bene cosa succede quando l’AI elimina un collo di bottiglia
L’articolo parte da AlphaFold perché rappresenta uno dei migliori esempi di ciò che l’intelligenza artificiale può fare quando un problema possiede abbastanza dati digitali e una metrica scientifica sufficientemente definita. Nel 2020 AlphaFold2 raggiunse nel benchmark CASP14 risultati tali da trasformare radicalmente la previsione delle strutture proteiche. Il database realizzato da Google DeepMind ed EMBL-EBI offre oggi centinaia di milioni di strutture previste e viene utilizzato in tutto il mondo.
Ma AlphaFold non ha reso istantanea la biologia. Conoscere una probabile struttura tridimensionale non stabilisce automaticamente come una proteina si comporti in una cellula, come interagisca con un farmaco, quale tossicità emerga o come cambino le sue conformazioni in condizioni differenti. Nel 2026 un lavoro pubblicato su Nature Biotechnology ha mostrato, per esempio, che AlphaFold3 tende a convergere verso una conformazione dominante anche quando la proteina esiste realmente come insieme dinamico di stati; integrando dati sperimentali provenienti da NMR, cristallografia e cryo-EM è possibile costruire ensemble molto più coerenti con ciò che viene misurato.
Ancora più significativo è ciò che sta avvenendo nel drug discovery. Nel settembre 2026 Nature ha riportato i risultati di una collaborazione fra aziende farmaceutiche che ha utilizzato oltre 20.000 strutture proteina-ligando proprietarie per migliorare OpenFold3. Su un test indipendente, il modello arricchito con dati industriali ha raggiunto un’elevata accuratezza su più della metà delle strutture analizzate, contro circa un terzo per il modello basato soltanto sui dati pubblici.
Il messaggio è importante: quando i modelli migliorano, spesso il nuovo collo di bottiglia diventa ottenere dati reali migliori.
L’Internet dei testi esiste già, l’Internet delle azioni robotiche no
Un robot industriale deve imparare informazioni completamente differenti rispetto a un LLM. Deve conoscere cosa accade se una pinza stringe un oggetto con una determinata forza, quanto un materiale possa scivolare, come cambia una presa se l’oggetto è ruotato di cinque gradi, cosa succede se una scatola è leggermente deformata o se una persona entra improvvisamente nell’area operativa.
Questi esempi non esistono online con la stessa densità del linguaggio umano.
NVIDIA identifica precisamente questo problema. Durante il keynote GTC Taipei 2026 Jensen Huang ha definito i dati il problema più difficile della physical AI. Gran parte dei video esistenti è registrata dalla prospettiva di un osservatore esterno, mentre un robot deve imparare dal proprio punto di vista, con informazioni su azioni, forze, posizione, stato dell’ambiente e conseguenze.
È per questo che lo sviluppo moderno della robotica combina sempre più spesso tre fonti:
dimostrazione umana → simulazione → esperienza reale.
La teleoperazione permette a una persona di mostrare al robot una sequenza corretta. La simulazione moltiplica digitalmente scenari e variazioni. Il deployment reale produce infine dati che nessuna simulazione riesce a rappresentare completamente.
I world model cercano di comprimere il mondo fisico dentro una simulazione
Una delle risposte più importanti a questa scarsità è rappresentata dai world models: modelli che cercano di prevedere come un ambiente cambierà in seguito a un’azione.
NVIDIA Cosmos, per esempio, viene proposto come foundation model per physical AI capace di combinare immagini, video, linguaggio, azioni e simulazione. Cosmos 3, presentato nel 2026, viene utilizzato per generare synthetic data, valutare robot policy e costruire modelli che prevedono sequenze future.
Wayve sta sviluppando una strategia simile per la guida autonoma. Con GAIA-4, presentato nell’agosto 2026, l’azienda ha spostato il concetto di world model dalla semplice generazione di scene a una simulazione closed-loop nella quale l’AI Driver prende decisioni e il mondo virtuale risponde alle sue azioni.
Questi sistemi possono creare milioni di situazioni senza far percorrere realmente milioni di chilometri a un veicolo o rompere migliaia di robot.
Ma la simulazione introduce un nuovo problema: sim-to-real.
Se il modello virtuale non rappresenta abbastanza bene attrito, luce, deformazione, comportamento umano, materiali e rumore dei sensori, il robot può diventare estremamente bravo a risolvere un mondo che non esiste.
La fabbrica diventa quindi anche una sorgente di training data
Questo passaggio è particolarmente interessante per la manifattura. Una fabbrica moderna non produce soltanto componenti. Produce continuamente:
- immagini;
- temperature;
- vibrazioni;
- log macchina;
- errori;
- manutenzioni;
- misure dimensionali;
- risultati di inspection;
- consumi;
- tempi ciclo.
Più una linea è digitalizzata, più ogni ciclo produttivo genera una coppia estremamente preziosa:
condizioni iniziali → risultato fisico.
Questo è esattamente il tipo di relazione che serve a un modello di physical AI.
La fabbrica può quindi diventare contemporaneamente mezzo di produzione e generatore di dati.
È una trasformazione concettuale non molto diversa da quella avvenuta con Internet: inizialmente la rete serviva a trasferire informazioni; successivamente quelle informazioni sono diventate il dataset che ha permesso di addestrare i modelli generativi. Oggi una linea automatizzata produce oggetti, ma i milioni di cicli che esegue potrebbero diventare il dataset utilizzato per addestrare i modelli industriali futuri.
La stampa 3D è probabilmente uno dei casi più interessanti
Una stampante additiva possiede una caratteristica molto utile per l’AI: collega già nativamente un file digitale a una trasformazione fisica.
Il processo parte da:
CAD → orientamento → slicing → parametri → macchina → materiale → parte.
Successivamente arrivano:
post-processing → metrologia → CT → test → accettazione o scarto.
Questo crea potenzialmente una catena di dati straordinariamente ricca.
Per una macchina Laser Powder Bed Fusion si possono avere, layer dopo layer:
- potenza laser;
- scan speed;
- hatch spacing;
- temperatura;
- oxygen level;
- immagini powder bed;
- optical tomography;
- melt-pool signal;
- recoater events.
Successivamente si possono associare:
- porosità CT;
- microstruttura;
- proprietà tensile;
- roughness;
- dimensional accuracy;
- fatigue life.
In teoria un modello può quindi imparare la relazione:
cosa è accaduto durante la stampa → cosa è accaduto dentro il componente.
È uno dei dataset più interessanti che la manifattura possa offrire.
Ma oggi gran parte di questi dati non è collegata
Il problema è lo stesso che abbiamo visto nei sistemi di qualification digitale come il progetto ESA DIQAM. Un file può trovarsi nel software della macchina, un altro nel MES, il certificato della polvere in PDF, la CT in un sistema metrologico e i tensile test nel database del laboratorio.
L’informazione esiste, ma non è necessariamente AI-ready.
Per addestrare seriamente un modello occorrerebbe sapere che:
questo segnale di melt pool appartiene al layer 1.542 della parte seriale X, prodotta con il powder batch Y, successivamente sottoposta al trattamento Z, nella quale CT ha rilevato una porosità specifica proprio in quella posizione.
Senza questa relazione semantica, avere terabyte di dati serve molto meno.
Un fallimento può valere più di cento stampe perfette
Esiste poi un problema molto particolare nella produzione.
Le aziende cercano naturalmente di eliminare i difetti.
L’AI, invece, ha bisogno di vedere anche i difetti.
Un dataset formato da 99,99% di build perfette e pochissimi esempi di:
- delamination;
- recoater streak;
- clog;
- warping;
- lack of fusion;
- overheating;
può essere poco utile per addestrare un sistema destinato precisamente a identificare quei fenomeni.
Il dato industriale più prezioso potrebbe quindi essere proprio quello che l’azienda normalmente considera uno scarto.
Questo crea anche un problema di incentivi: chi finanzia intenzionalmente build difettose soltanto per raccogliere training data?
La simulazione e il synthetic data possono aiutare, ma alla fine almeno una parte delle correlazioni deve essere verificata fisicamente.
La grande print farm può diventare una data factory
L’articolo di partenza utilizza come esempio Huafast a Shenzhen. Durante una visita nell’agosto 2026, Michael Petch ha osservato un sito con migliaia di Bambu Lab inserite in una rete produttiva più ampia. La società dichiara oggi sul proprio sito una flotta dell’ordine di 10.000 stampanti Bambu Lab; nel reportage vengono citate circa 5.600 macchine nel sito visitato e circa 15.000 acquistate/operate dalla rete più ampia. Sono cifre aziendali e non perfettamente allineate fra le diverse comunicazioni, quindi vanno interpretate come ordine di grandezza più che come conteggio indipendentemente certificato.
Il punto però rimane.
Immaginiamo 10.000 stampanti che lavorano:
12 ore al giorno × 300 giorni = 36 milioni di machine-hours all’anno.
Il numero è soltanto un esempio matematico, ma mostra la scala possibile.
Dentro quelle ore ci sarebbero combinazioni di:
- PLA;
- PETG;
- TPU;
- temperature;
- geometrie;
- nozzle;
- manutenzione;
- errori;
- sostituzioni parti;
- differenti operatori.
Se questi dati fossero collegati alla qualità del prodotto finale, una print farm potrebbe diventare una straordinaria infrastruttura per addestrare sistemi di predictive maintenance, automatic parameter selection e failure detection.
Non risulta che Huafast stia oggi utilizzando l’intera propria produzione per addestrare un foundation model di questo genere. L’esempio serve a mostrare il valore informativo potenziale prodotto dalla scala.
La Cina ha già trasformato questa intuizione in politica industriale per la robotica
Nel giugno 2026 il Ministero cinese dell’Industria e dell’Information Technology e la State-owned Assets Supervision and Administration Commission hanno avviato un programma nazionale dedicato al real-world training di humanoid robot ed embodied intelligence.
La strategia è estremamente esplicita: aprire vere aree di produzione, logistica, manutenzione, retail, sanità ed emergency response e usarle come:
training space → data generation → product improvement → deployment.
Il programma nazionale punta entro la fine del 2026 a identificare oltre 100 scenari ad alto valore e a creare capacità per deployment su scala di circa 10.000 unità.
Non è soltanto una politica per finanziare robot.
È una politica per finanziare ambienti nei quali i robot possano produrre dati.
A Pechino questi ambienti esistono già
Il Beijing Innovation Center of Humanoid Robotics ha realizzato training base che riproducono:
- abitazioni;
- supermercati;
- uffici;
- officine;
- strutture sanitarie.
Gli operatori fanno eseguire ai robot centinaia o migliaia di volte operazioni apparentemente banali come prendere una verdura, pesarla e riposizionarla, modificando continuamente posizione e oggetti per impedire che il sistema impari una semplice sequenza fissa.
Un altro centro nel distretto di Shijingshan dichiarava nel maggio 2026 quasi 270 robot impegnati nella raccolta dati e una capacità annuale vicina a 20 milioni di data record.
Nel settembre 2026 il centro è stato ulteriormente ampliato con una catena che comprende:
data acquisition → simulation generation → model training → robot validation → deployment.
Questo rende molto concreto il concetto di physical AI infrastructure.
Non basta costruire il robot.
Bisogna costruire anche la scuola nella quale impara.
NVIDIA sta costruendo la versione virtuale della stessa infrastruttura
La strategia NVIDIA è complementare.
Nel marzo 2026 l’azienda ha presentato il Physical AI Data Factory Blueprint, un’architettura destinata a combinare:
- data curation;
- synthetic data;
- reinforcement learning;
- simulation;
- evaluation.
Nel frattempo ABB, FANUC, KUKA e Yaskawa — che insieme rappresentano un’install base superiore ai due milioni di robot secondo NVIDIA — stanno integrando Omniverse e Isaac per costruire digital twin di robot e linee produttive.
L’idea è utilizzare il mondo virtuale per moltiplicare gli scenari e quello fisico per correggere continuamente la simulazione.
La strategia più plausibile non è quindi:
simulation oppure reality.
È:
simulation ↔ reality.
Il digital twin genera esperienze economiche. La fabbrica fornisce il ground truth. Il modello viene aggiornato e ritorna nella simulazione.
È esattamente quello che potrebbe accadere anche nell’additive manufacturing
Un futuro modello AM potrebbe simulare migliaia di combinazioni di parametri e selezionare le più promettenti.
Le macchine reali ne testerebbero soltanto una piccola parte.
CT e mechanical testing fornirebbero il risultato.
Il modello aggiornerebbe quindi la propria rappresentazione.
In forma semplificata:
simulation → parameter proposal → physical build → inspection → learning → nuova simulazione.
È la stessa logica utilizzata sempre più spesso nel materials discovery.
La differenza è che l’obiettivo non sarebbe soltanto trovare una nuova lega, ma imparare continuamente come produrla.
Generative design e manufacturing intelligence sono due problemi differenti
Negli ultimi anni l’AI applicata alla stampa 3D è stata spesso presentata attraverso immagini spettacolari di componenti generati automaticamente.
Ma creare una geometria è probabilmente la parte più semplice.
Un algoritmo può proporre in pochi secondi:
- una staffa alleggerita;
- un heat exchanger;
- un lattice;
- un manifold.
Poi arrivano domande molto meno visuali:
- può essere stampato?
- in quale orientamento?
- con quali supporti?
- con quale alloy?
- con quale parameter set?
- con quale distorsione?
- quale superficie richiede machining?
- la porosità è accettabile?
- quanto durerà a fatica?
L’intelligenza industriale utile deve quindi collegare design e process knowledge.
Un componente generato dall’AI ma impossibile da qualificare ha poco valore.
La materia non permette all’AI di “allucinare” indefinitamente
È una delle differenze più profonde fra cognitive e physical AI.
Un modello può inventare una citazione inesistente e l’errore rimane nel dominio dell’informazione.
Se inventa:
- yield strength;
- temperatura di fusione;
- laser power;
- tolleranza;
- proprietà di fatica;
prima o poi l’errore incontra un test fisico.
Il componente si deforma.
La macchina fallisce.
La CT trova il poro.
Il tensile specimen si rompe.
La realtà fornisce una funzione di perdita estremamente severa.
Questo può rendere la physical AI contemporaneamente più difficile e scientificamente più interessante: molte sue previsioni possono essere verificate attraverso misure fisiche molto chiare.
Anche la biologia sta costruendo le proprie data factory
Bioptimus offre un altro esempio.
L’azienda francese sta costruendo foundation model biologici, ma nel marzo 2026 ha lanciato STELA, un programma destinato a raccogliere dati spatial biology da fino a 100.000 campioni di pazienti su tre continenti.
Il motivo dichiarato è precisamente la scarsità di dataset biologici standardizzati e AI-ready.
In collaborazione con 10x Genomics e Broad Clinical Labs vengono generati:
- spatial transcriptomics;
- pathology images;
- multi-omics;
- clinical data.
In giugno è stato inoltre aggiunto un dataset collegato a oltre 3.000 pazienti oncologici della Fédération Francophone de Cancérologie Digestive.
Quindi l’azienda che costruisce il modello deve contemporaneamente contribuire a costruire il mondo di dati dal quale il modello impara.
È la stessa trasformazione che potrebbe interessare la manifattura.
Il controllo del dataset può diventare un vantaggio competitivo più forte del modello
I foundation model possono essere replicati, open-sourced o sostituiti relativamente rapidamente.
Un dataset costituito da:
- vent’anni di produzione;
- milioni di build;
- maintenance history;
- CT;
- test distruttivi;
- field failures;
è molto più difficile da replicare.
Questo apre una questione importante per il settore AM:
chi possiede il manufacturing dataset?
Il costruttore della stampante possiede i machine log?
Il service bureau possiede la storia delle build?
Il produttore della polvere conosce la genealogy del materiale?
Il cliente aerospace possiede inspection e fatigue data?
Il MES possiede le relazioni fra job?
Il fornitore CT possiede le immagini?
Ognuno detiene un pezzo del puzzle.
Il modello migliore potrebbe essere quello dell’azienda che riesce non semplicemente ad avere più dati, ma a collegarli.
La privacy industriale rende però difficile costruire un “Internet della manifattura”
Un produttore aeronautico non vuole necessariamente condividere:
- CAD;
- parameters;
- failure data;
- production rate.
Sono informazioni che possono essere commercialmente o militarmente sensibili.
La physical AI industriale potrebbe quindi svilupparsi in modo molto differente dagli LLM pubblici.
Piuttosto che un gigantesco dataset universale potremmo vedere:
- modelli proprietari;
- federated learning;
- secure data spaces;
- on-premise training.
Un produttore potrebbe contribuire al miglioramento di un modello senza trasferire fuori dalla fabbrica i propri raw data.
È precisamente il tipo di problema che progetti AM recenti sulla federated AI stanno già cercando di affrontare.
L’altra grande difficoltà è che due macchine apparentemente uguali non producono necessariamente dati identici
Una camera registra immagini con un’esposizione leggermente diversa.
Un sensore viene sostituito.
Il firmware cambia.
La polvere appartiene a un nuovo batch.
Il nozzle accumula usura.
Il modello deve quindi imparare non soltanto il processo ma anche la provenance del dato.
Questo è uno dei motivi per cui digital thread e qualification database diventeranno probabilmente infrastrutture essenziali prima ancora dei modelli più avanzati.
Se l’AI non sa da quale macchina proviene un’immagine o in quali condizioni è stata registrata, può imparare correlazioni completamente sbagliate.
Il problema non è quindi soltanto avere più dati, ma dati migliori
Un milione di immagini senza label può valere meno di mille immagini associate a:
- geometria;
- processo;
- CT;
- failure mode.
È la stessa lezione che emerge dalle strutture proteiche private utilizzate nel nuovo lavoro riportato da Nature.
Il vantaggio non deriva soltanto da 20.000 strutture in più.
Deriva dal fatto che rappresentano informazioni particolarmente rilevanti per il problema proteina-ligando che mancavano nei database pubblici.
Per la manifattura vale lo stesso.
Milioni di temperature genericamente registrate sono meno utili di migliaia di build nelle quali la temperatura sia collegata a un risultato fisico misurato.
L’AI industriale avrà bisogno di una quantità enorme di metrologia
È un paradosso interessante.
Si parla spesso di AI come strumento destinato a eliminare inspection e testing.
Nella fase di apprendimento potrebbe accadere esattamente il contrario.
Per dimostrare che un modello riesca a predire porosità senza CT, occorrono molte CT con cui confrontarlo.
Per predire fatigue life occorrono fatigue test.
Per imparare la distorsione occorrono scansioni dimensionali.
La physical AI può quindi generare inizialmente maggiore domanda di metrologia, perché il sistema ha bisogno di ground truth.
Soltanto dopo avere dimostrato una correlazione sufficientemente robusta può diventare realistico ridurre alcuni controlli.
Lo stesso vale per la robotica
Un robot può essere addestrato per migliaia di ore in simulazione.
Prima di entrare in fabbrica deve comunque dimostrare:
- collision avoidance;
- force limits;
- reliability;
- safe stop;
- cyber security;
- comportamento in failure mode.
Quando lavora vicino alle persone, il costo di un errore è completamente differente dal costo di una risposta sbagliata di un chatbot.
Per questo la physical AI non è soltanto un problema di modello.
È anche:
hardware + sensoristica + safety + validation + maintenance.
Nick Clegg mette in dubbio che basti semplicemente scalare i transformer
Al Sifted Summit, Nick Clegg, oggi General Partner di Hiro Capital dopo essere stato presidente Global Affairs di Meta e vice primo ministro britannico, ha definito la generative AI una tecnologia contemporaneamente potentissima e “monstrously inefficient”. Ha inoltre espresso dubbi sull’idea che continuare semplicemente a ingrandire gli attuali transformer produca inevitabilmente un’intelligenza capace di comprendere il mondo fisico.
È una posizione, non un risultato scientifico.
Ma individua una questione reale: prevedere il prossimo token è un obiettivo differente dal mantenere una rappresentazione coerente di oggetti, spazio, causalità e conseguenze delle azioni.
Altre aziende stanno infatti esplorando architetture differenti.
Stanhope AI parte dalla neuroscienza invece che dai transformer
Rosalyn Moran, CEO di Stanhope AI e professoressa di computational neuroscience, sta sviluppando sistemi basati sull’Active Inference e sul Free Energy Principle associato ai lavori di Karl Friston.
L’idea è costruire agenti che mantengano internamente un modello probabilistico del proprio ambiente e prendano azioni per ridurre l’incertezza fra ciò che prevedono e ciò che osservano.
Stanhope sostiene che questo permetta decisioni più locali ed efficienti rispetto a sistemi che dipendono continuamente da grandi server remoti.
La tecnologia è già stata sperimentata su droni e autonomous systems, ma non esiste ancora evidenza che l’Active Inference sostituirà i transformer come paradigma dominante della physical AI.
È però un esempio utile: la futura intelligenza fisica potrebbe non essere semplicemente ChatGPT dentro un robot.
Physical AI e cognitive AI probabilmente continueranno a convergere
Wayve utilizza modelli vision-language-action.
NVIDIA combina vision, language, world models e action models.
La distinzione più utile non è quindi stabilire quale singola architettura vincerà.
È chiedersi quale output debba produrre il sistema.
Un cognitive model può rispondere:
“la scatola è davanti a te”.
Un physical model deve decidere:
“muovi il braccio di 42 centimetri, chiudi la pinza con questa forza e correggi la traiettoria se l’oggetto scivola”.
L’informazione diventa controllo.
Per l’Europa questo può cambiare le regole competitive
Nel software puro, Stati Uniti e Cina possiedono enormi vantaggi in:
- hyperscale compute;
- capitale;
- foundation models.
La physical AI aumenta invece il peso di asset nei quali l’Europa possiede ancora forti competenze:
- automotive;
- aerospace;
- machine tools;
- industrial robotics;
- metrology;
- manufacturing;
- medical technology.
È probabilmente questo il significato politico della riflessione del ministro britannico per l’AI Kanishka Narayan, che al Sifted Summit ha parlato anche della “geography of build”: non conta soltanto dove viene sviluppato il modello, ma dove esistono le infrastrutture che permettono di trasformarlo in prodotti fisici.
Un’azienda può affittare GPU in un altro continente.
È molto più difficile affittare online:
- un aeroporto;
- una fabbrica automobilistica;
- un reparto ospedaliero;
- un impianto chimico;
- migliaia di robot;
- milioni di ore di produzione.
Questi asset diventano parte della competizione tecnologica.
Ma “il mondo fisico è il prossimo bottleneck” non deve diventare un’altra formula semplicistica
La physical AI non possiede un solo collo di bottiglia. Ne possiede molti.
Oltre ai dati ci sono:
- attuatori;
- motori;
- riduttori;
- batterie;
- energia;
- sensori;
- sicurezza;
- supply chain;
- certificazione;
- costi;
- manutenzione.
Nel settore dei robot umanoidi, per esempio, proprio gli attuatori ad alte prestazioni stanno emergendo come uno dei componenti industriali più difficili da produrre economicamente su larga scala.
Nel settore automotive il problema non è soltanto insegnare a un veicolo a guidare, ma dimostrare statisticamente che lo faccia con un livello di rischio accettabile.
In additive manufacturing il problema non è soltanto predire i parametri, ma qualificare il componente.
Quindi il “physical bottleneck” è in realtà un insieme di vincoli che il software aveva potuto in gran parte evitare.
È qui che la stampa 3D potrebbe avere un ruolo più importante di quanto sembri
Additive manufacturing può contribuire alla physical AI in almeno due modi differenti.
Il primo è produrre rapidamente:
- end-effector;
- robot gripper;
- sensor housing;
- lightweight structures;
- cooling channels;
- actuator parts;
- prototipi.
Questo accelera il ciclo hardware.
Il secondo è ancora più interessante: creare dati.
Una stampante controllata digitalmente produce un esperimento fisico altamente documentabile. Modificando un parametro alla volta è possibile costruire dataset che collegano direttamente la decisione digitale al risultato materiale.
In questo senso un laboratorio AM può diventare una specie di robot scientist per la manifattura.
Il modello propone.
La macchina produce.
La metrologia misura.
Il modello impara.
Il ciclo chiuso è probabilmente il vero obiettivo
Quando tutti questi elementi saranno realmente collegati, il workflow potrebbe diventare:
design AI → simulation → manufacturing → inspection → learning → redesign.
Oggi ogni passaggio esiste già separatamente.
La vera difficoltà è chiudere il loop senza che un essere umano debba trasferire manualmente file e interpretazioni fra sistemi differenti.
È precisamente qui che si incontrano molte delle tendenze che stiamo osservando nel 2026:
- digital qualification;
- machine monitoring;
- anomaly detection;
- autonomous laboratories;
- world models;
- digital twins;
- AI-driven materials discovery.
Non sono fenomeni separati.
Sono tentativi differenti di collegare modello digitale e conseguenza fisica.
La realtà diventa il sistema di valutazione finale
La più grande forza della physical AI potrebbe quindi coincidere con la sua più grande difficoltà.
Nel mondo digitale un benchmark è costruito dagli esseri umani.
Nel mondo fisico esistono benchmark molto più duri:
l’auto evita l’ostacolo oppure no.
Il robot prende l’oggetto oppure lo lascia cadere.
Il componente resiste oppure si rompe.
La parte entra nella tolleranza oppure viene scartata.
Questo rende il training costoso, ma permette anche di costruire funzioni di ricompensa molto meno ambigue.
In un certo senso la materia stessa diventa il supervisore.
La prossima grande infrastruttura AI potrebbe quindi non assomigliare a un data center
Potrebbe essere una fabbrica.
Un laboratorio biologico.
Un circuito di guida.
Una rete di robot.
Una print farm.
Il valore di queste infrastrutture non risiederà soltanto in ciò che producono, ma nella capacità di trasformare ogni azione fisica in un nuovo dato utilizzabile per migliorare il modello successivo.
È una trasformazione importante anche per interpretare economicamente l’additive manufacturing.
Una fabbrica con migliaia di stampanti può sembrare meno sofisticata di un hyperscale data center. Ma se registra sistematicamente materiale, parametri, errori, manutenzione e risultati di milioni di lavori, accumula un asset estremamente difficile da replicare.
L’Internet ha fornito gratuitamente gran parte del dataset che ha reso possibile la prima generazione di AI.
La physical AI non avrà necessariamente lo stesso privilegio.
Potrebbe dover costruire, simulare, guidare, stampare, rompere e misurare il proprio dataset.
Ed è probabilmente questo il senso più interessante della tesi secondo cui il mondo fisico è il prossimo collo di bottiglia dell’intelligenza artificiale: non perché i modelli abbiano improvvisamente smesso di migliorare, ma perché più diventano capaci di proporre azioni, più aumenta il valore delle infrastrutture che possono verificare quelle azioni nella realtà.
Per la manifattura additiva questo significa che la prossima competizione potrebbe non riguardare soltanto chi possiede la stampante più veloce.
Potrebbe riguardare chi possiede il miglior collegamento fra milioni di ore macchina e ciò che quelle ore hanno realmente prodotto.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).